- Hjemmeside /
- Bøker /
- Datamaskiner og teknologi /
- Informatikk /
- AI & Machine Learning /
- Intelligence & Semantics /
- Reinforcement Learning from Human Feedback: L...
0 ratings


vare #:
248983336
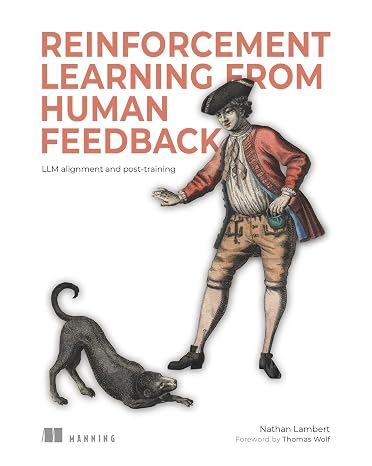
Reinforcement Learning from Human Feedback: LLM alignment and post-training
89% av respondentene vil anbefale dette til en venn
vare #:
248983336
NOK 892
Prisdetaljer
Eksklusive frakt- og tollkostnader ( Frakt- og tollkostnader beregnes ved kassen )
*Alle varer importeres fra USA
0 ratings
Skriv en vurdering
På lager
 Importert fra USA-butikk
Antall:
Bestill nå, så får du den omkring Tirsdag, Oktober 20
Sikker transaksjon
Ubuy arbeider hardt for å beskytte din sikkerhet og personvern. Vårt avanserte betalingssikkerhetssystem sikrer konfidensialitet ved å kryptere informasjonen din under overføring ved hjelp av AES (Advanced Encryption Standards) og SSL (Secure Socket Layer)-protokoller. Betalingsopplysningene dine er 100 % sikre da vi ikke deler betalingsopplysningene dine med tredjepartsselgere.
Våre beste leveringspartnere


Reinforcement Learning from Human Feedback helps you understand one of the most important techniques behind modern LLM alignment and post-training.

Fast
Shipping

Gratis
retur*

Sikret innpakking

100 % originale produkter

PCI DSS-samsvar

ISO 27001-sertifisert
Note: Step Down Voltage Transformer required for using electronics products of USA store (110-120). Recommended power converters Kjøp nå.


Det som utmerker seg
Human-Centric Training
Utilizes human feedback to fine-tune models, ensuring that AI aligns closely with user values and preferences, enhancing satisfaction and real-world applicability.
Post-Training Optimization
Offers advanced techniques for model alignment after initial training, ensuring continual improvement and adaptation, which outperforms static models in dynamic environments.
Enhanced Safety Measures
Integrates rigorous safety protocols to minimize risks associated with AI decision-making, providing users and developers with greater confidence in AI deployment.
Produkt detaljer
- Get the eBook free when you register your print book at Manning.A masterful synthesis of the field’s intellectual roots and its practical tools.”—Saurabh Sawant, MicrosoftReinforcement Learning from Human Feedback: LLM alignment and post-training helps you understand how modern AI models can be adapted to better match the needs and expectations of their users. Rather than surveying the vast field of reinforcement learning, elite AI researcher Nathan Lambert concentrates exclusively on RLHF and its immediate importance to post-training generative AI models.This compact book gets right to the point. Early chapters establish the training overview, explain instruction fine-tuning, and build reliable reward models. The middle chapters transition into the heart of alignment, exploring core policy gradient algorithms, Direct Preference Optimization (DPO), and inference-time scaling. Later chapters tackle the messy reality of data, guiding you through preference data collection, synthetic data generation, and the nuances of function calling.As you go, you will see how these post-training methods actually work, including their unique compute costs and latency trade-offs. You will explore common failure modes, such as qualitative over-optimization, reward hacking, and the unreliability of external evaluation comparisons. Difficult concepts like KL regularization, proximal policy optimization, and generative reward modeling are clarified with hands-on experiments.Reinforcement Learning from Human Feedback avoids irrelevant academic details in favor of immediate, practical value. Everything author Nathan Lambert includes appears because a modern RLHF project requires it. He skillfully explains complex post-training pipelines by making every detail concrete, connecting isolated abstractions directly to the goal of making models safer, smarter, and perfectly tuned to a desired style.The book’s seventeen short chapters lay out the core material, while supplements like vocabulary definitions, compute cost management, evaluation variance, and training performance tracking appear in handy appendixes. The result is a logically flowing book that remains highly navigable and technically deep without getting bogged down in unnecessary theory.The book covers• Core RLHF implementations and Direct Alignment Algorithms• Building robust preference and synthetic data pipelines• Evaluating models and crafting specific AI personasAbout the readerFor established engineers, AI scientists, and students trying to get a practical foothold in AI model alignment.About the authorDr. Nathan Lambert is a leading AI researcher known for leading post-training at the Allen Institute for AI. With previous experience at HuggingFace, DeepMind, and Meta, he is a passionate advocate for open models. His work focuses on increasing access to, and the understanding of, AI technology—empowering readers to contribute to the advancement of AI outside closed corporate labs.Table of ContentsPart 11 Introduction2 A tiny history of RLHF3 Training overviewPart 24 Instruction fine-tuning5 Reward modeling6 Reinforcement learning7 Reasoning and inference-time scaling8 Direct-alignment algorithms9 Rejection samplingPart 310 The nature of preferences11 Preference data12 Synthetic dataPart 413 Tool use and function calling14 Over-optimization15 Regularization16 Evaluation17 Crafting model character and productsA DefinitionsB Beyond “just style”C Practical Issues
| Publisher | Manning Publications |
| Publication date | August 4, 2026 |
| Language | English |
| Print length | 312 pages |
| ISBN-10 | 1633434303 |
| ISBN-13 | 978-1633434301 |
| Item Weight | 8.5 ounces (240.98 grams) |
| Dimensions | 7.38 x 0.71 x 9.25 inches (18.7 x 1.8 x 23.5 cm) |
PRODUKTBESKRIVELSE
Har du noen spørsmål? Chat med oss
Kundespørsmål og svar
-
Spørsmål:
Hvordan handle Reinforcement Learning from Human Feedback: LLM online fra Ubuy?
Svar: Det er enkelt å handle Reinforcement Learning from Human Feedback: LLM online fra Ubuy.. Du trenger bare å søke etter produktet, velge fraktmetode mens du sjekker ut og få det levert til ditt sted. -
Spørsmål:
Er Reinforcement Learning from Human Feedback: LLM tilgjengelig for nettbutikk i Norway?
Svar: Ja, hos Ubuy Norway er dette produktet tilgjengelig for deg å handle til en rimelig pris.. Reinforcement Learning from Human Feedback: LLM er ikke tilgjengelig lokalt, men du kan stole på oss med våre ekspressfrakttjenester. -
Spørsmål:
Hvor lang tid tar det å få produktet etter bestillingen?
Svar: Leveringstiden for det bestilte produktet ditt varierer i henhold til hva du har bestilt og fraktmetoden du har valgt.. Den estimerte leveringstiden er nevnt under utsjekkingsprosessen, så vær bekymringsløs mens du handler.
Intelligence & Semantics Editorial Review
Ingen redaksjonelle anmeldelser funnet
Kundeanmeldelser og vurderinger
1 kunders vurderinger
-
5 stjerne
100%
-
4 stjerne
0%
-
3 stjerne
0%
-
2 stjerne
0%
-
1 stjerne
0%
Vurder dette produktet
Del tankene dine med andre kunder
Produktets prishistorikk
Viktig informasjon
- Begrensninger: For produkter som sendes internasjonalt, vær oppmerksom på at eventuell produsentgaranti kan være ugyldig; produsentens serviceordninger er kanskje ikke tilgjengelige; produktmanualer, instruksjoner og sikkerhetsadvarsler er kanskje ikke på mottakerlandets språk; produktene (og medfølgende materiell) er kanskje ikke utformet i samsvar med mottakerlandets standarder, spesifikasjoner og merkekrav; og produktene samsvarer kanskje ikke med mottakerlandets krav til spenning og andre elektriske standarder (noe som kan kreve bruk av adapter eller omformer om nødvendig). Mottakeren er ansvarlig for å sikre at produktet lovlig kan importeres til mottakerlandet. Ved bestilling fra Ubuy eller dets datterselskaper er mottakeren registrert importør og må overholde alle lover og forskrifter i mottakerlandet.
- Ikke alle produkter som er oppført på Ubuy er til salgs, da Ubuy er en global søkemotor. Produkter er underlagt eksport-/handelsreguleringer.
NOK 892
Bestill nå, så får du den omkring Tirsdag, Oktober 20
Denne varen er ikke underlagt restriksjoner i mitt land. (Klikk på lenken over hvis varen ikke er begrenset i ditt land, så vil teamet vårt vurdere og godkjenne den.)
Antall:
Sikker transaksjon
PCI DSS-kompatibel og ISO 27001:2022-sertifisert, med krypterte betalinger og full kjøperbeskyttelse på hver bestilling.
Våre beste leveringspartnere
Raskeste grenseoverskridende levering
Funksjoner og fordeler
- Gain insights into aligning AI models with human preferences.
- Practical guidance on reinforcement learning and its components.
- Focus on RLHF's impact on generative AI models.
- Hands-on experiments clarify complex concepts.
- Avoids unnecessary academic details for immediate application.
- Ideal for AI engineers, researchers, and technical leaders.
Ubuy-garanti
Opplev bekymringsfri shopping med 100 % originale produkter, PCI DSS-kompatibel betalingssikkerhet, ISO 27001-sertifisert databeskyttelse, den raskeste grensekryssende leveringen, gratis retur, og sikker emballasje på hver bestilling.*